Formación de haces en ultrasonidos médicos: cadena de señal de 128 canales y presupuesto de velocidad de datos
Una sonda de ecografía a color de 128 canales muestra cada canal con un ADC de 12 bits y 40 MS/s, lo que da una velocidad de datos en bruto de unos 7,7 GB/s: un nivel que una CPU no puede absorber, y mucho menos generar imagen en tiempo real. El enfoque correcto es ejecutar primero el beamforming, la detección de envolvente y el submuestreo dentro del FPGA, y entregar al host solo los datos de imagen comprimidos. Este artículo descompone la cadena de 128 canales en etapas, presupuesta la velocidad de datos en cada paso, y explica exactamente qué hace el FPGA en medio.
1. Toda la cadena de señal de imagen por ultrasonidos
Desde el array de la sonda hasta la imagen en escala de grises en pantalla, la señal recorre una cadena larga, con el FPGA situado tras el frontend analógico y antes de la imagen en el host:
1. Array de la sonda (128 elementos): emite ultrasonidos y recibe los ecos del tejido; cada elemento se corresponde con un canal independiente.
2. Frontend analógico (AFE): compensación de ganancia temporal TGC → filtro pasa-banda → amplificación de ganancia variable → digitalización ADC.
3. Beamforming en el FPGA: retardo programable por canal, ponderación y suma en una línea de exploración, completando el enfoque dinámico.
4. Demodulación IQ + submuestreo + detección de envolvente: comprime la señal de RF de alta frecuencia en datos de amplitud en escala de grises.
5. Conversión de scan + buffer de fotograma + subida PCIe: convierte las líneas de exploración polares a cartesianas, y las envía al host para el DSC y el mapeo de color.
La razón por la que los pasos 3 y 4 deben ejecutarse en el FPGA es directa: 128 canales deben alinearse, retardarse y sumarse ponderadamente en microsegundos, cambiando cada retardo de forma dinámica con la profundidad. Es un trabajo altamente paralelo, por canal, de temporización determinista; el software sobre una CPU de propósito general carece tanto de paralelismo como de velocidad de cuadro en tiempo real.
2. Presupuesto de velocidad de datos de 128 canales (calcule antes de conectar)
El presupuesto parte del ADC de un solo canal y multiplica hacia arriba. Tomemos un ADC de 12 bits y 40 MS/s:
| Etapa | Velocidad por canal | Total 128 canales | Nota |
|---|---|---|---|
| Muestreo en bruto del ADC | 12 bit × 40 MS/s = 480 Mb/s (60 MB/s) | 128 × 480 = 61440 Mb/s ≈ 61,4 Gb/s (7,68 GB/s) | Pico en bruto que entra al FPGA |
| Beamforming (suma retardada) | 128 canales sumados ponderadamente → 1 línea de exploración | Ya no hay 128 caminos paralelos tras la suma | El paralelismo se comprime aquí |
| Demodulación IQ + diezmado CIC/FIR | RF 40 MS/s → ~10 MS/s equivalente complejo | Camino único ~20 MB/s (complejo 12 bits) | Bajo 1/4 del bruto tras la diezmación |
| Detección de envolvente + compresión logarítmica | Amplitud 8 bits, ~10 MS/s | Camino único ~10 MB/s | Rango dinámico comprimido a 40–60 dB |
| Subida PCIe al host | — | 256 líneas × 60 fps × 8 bit ≈ 122 MB/s | La CPU solo maneja este nivel |
Conclusión clave: la compresión ocurre dentro del FPGA. Lo que entra al FPGA es un flujo paralelo en bruto de 61,4 Gb/s; lo que sale hacia el host es solo unos 122 MB/s de datos de fotograma en escala de grises. La relación de compresión supera 60×, lograda al fusionar el beamforming 128 caminos en uno, y luego colapsar la RF de alta frecuencia en una envolvente de amplitud mediante el submuestreo y la detección. Omita el FPGA y empuje el flujo en bruto de 7,68 GB/s a una CPU, y ni el ancho de banda de memoria ni PCIe podrán con él.
Velocidad de cuadro frente a número de líneas de exploración
En el beamforming, cada línea de exploración requiere una nueva suma retardada de 128 canales. Sea N líneas por fotograma a una velocidad de cuadro F; el FPGA debe completar N×F sumas por segundo. Con N=256 y F=60 fps, eso son 256 × 60 = 15360 líneas de exploración por segundo, sumando cada una 128 muestras ponderadas y retardadas: el punto de partida para dimensionar los multiplicadores del FPGA (DSP) y la RAM en chip (FIFOs de línea de retardo).
3. Cómo se divide la cadena interna del FPGA
1. Adquisición sincronizada y alineación de canales
Los 128 canales suelen abarcar varios AFE que entran al FPGA por JESD204B o LVDS paralelo. La primera compuerta es la compensación de skew: las longitudes de pista difieren por canal, por lo que las muestras deben alinearse a una referencia de reloj única antes de la FIFO; de lo contrario, la suma retardada desalinearía la fase, produciendo lóbulos laterales y artefactos fantasma.
2. Suma retardada de enfoque dinámico
Cada elemento está a una distancia distinta del punto de enfoque, por lo que los ecos llegan en momentos diferentes. El FPGA compensa esta diferencia temporal por canal con líneas de retardo programables (FIFOs ajustables por profundidad o retardos tocados), luego multiplica por un peso de apodización y suma. La profundidad de enfoque se mueve con la compuerta temporal, por lo que los parámetros de retardo se refrescan por segmento; esto consume gran cantidad de BRAM en chip y DSP para el multiplicar-acumular.
3. Demodulación IQ, submuestreo y detección de envolvente
La línea RF sumada pasa primero por una demodulación en cuadratura (mezcla I/Q), luego una cascada CIC + FIR diezmando la frecuencia de muestreo; una transformada de Hilbert encuentra la envolvente, y la compresión logarítmica mapea el amplio rango dinámico a escala de grises de 8 bits. Esta etapa es un filtrado en tubería típico: alta utilización de DSP pero bajo paralelismo.
4. Conversión de scan, buffer de fotograma y subida
Las líneas de exploración polares en abanico se remuestrean a píxeles rectangulares cartesianos, se escriben en un buffer de fotograma DDR3/4, y luego el DMA envía el fotograma completo por PCIe al host. Esta etapa se preocupa por el ancho de banda de lectura/escritura DDR y el motor DMA, no por el rendimiento del DSP.
4. Caso de ingeniería: dimensionado de un frontend de ecografía a color portátil
Un frontend de ecografía a color portátil usa un AFE de 128 canales que muestrea la RF a 40 MS/s, 12 bits. El beamforming debe procesar 128 líneas de retardo y multiplicaciones ponderadas en paralelo, además de un canal Doppler de flujo sanguíneo. Según el presupuesto anterior, los 61,4 Gb/s en bruto se comprimen dentro del FPGA en unos 122 MB/s de fotogramas en escala de grises; un ancho de banda neto de PCIe Gen2 x4 lo transporta con comodidad.
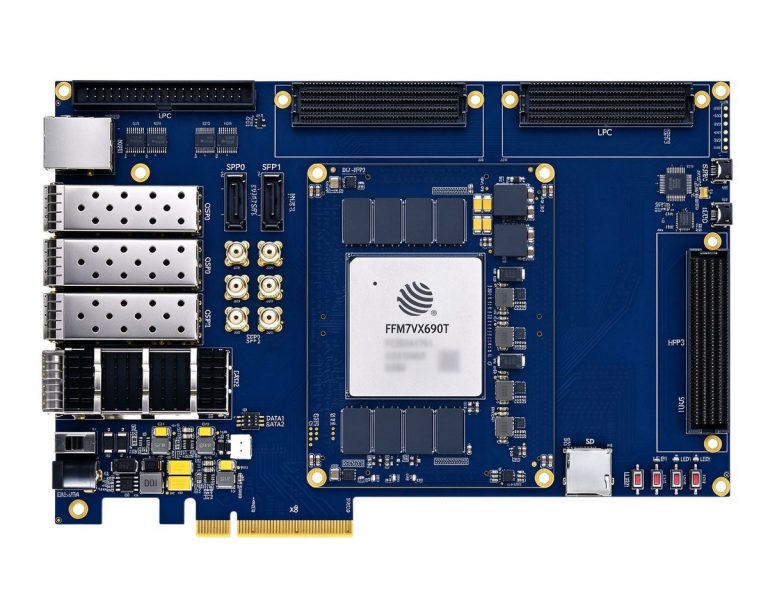
- Alta capacidad (DUF7690T / JFM7VX690T): amplia lógica y RAM en chip para sostener a la vez 128 FIFOs de línea de retardo, la síntesis en escala de grises y el canal Doppler; adecuado para un diseño completo de 128 canales y alta velocidad de cuadro.
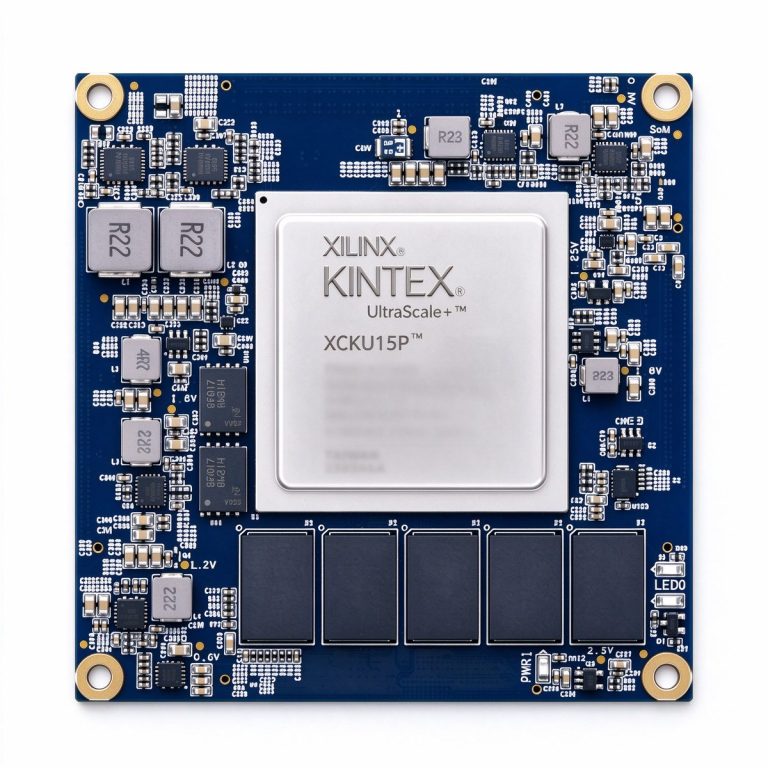
- Ampliación de alto número de canales (XCKU15P): transceptores potentes y agregación LVDS multicanal; adecuado para seguir ampliando canales o sondas distribuidas que envían datos AFE de vuelta por fibra.
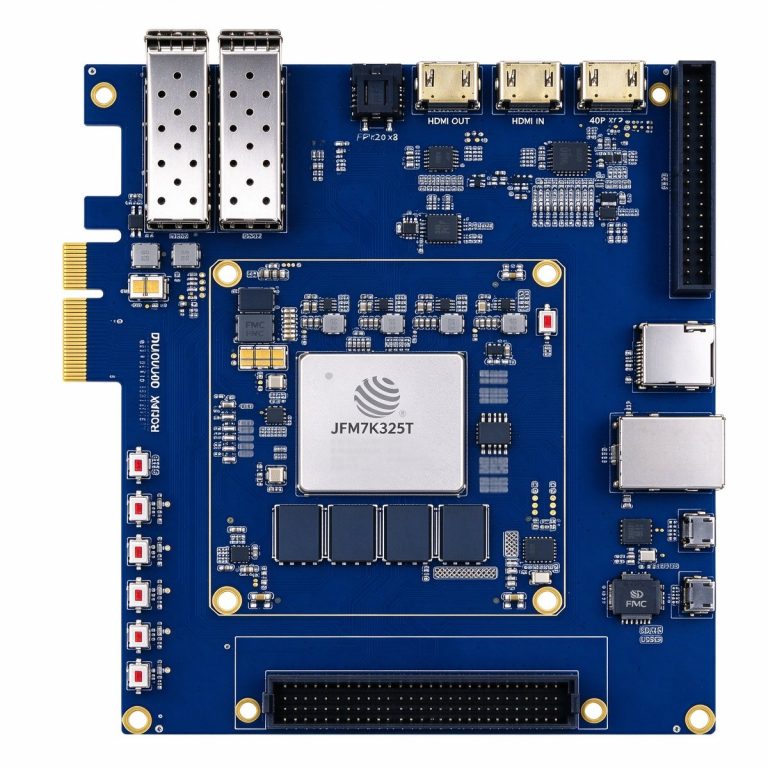
- Entrada de gama media (DUK7325T / JFM7K325T): recursos y coste equilibrados; adecuado para prototipado en escala de grises de 64–128 canales y productos de gama media-baja: ejecute aquí la cadena de suma retardada y detección antes de pasar a una plataforma de alta capacidad.
La imagen por ultrasonidos es, en esencia, usar la suma retardada paralela dentro del FPGA para convertir 128 ecos en bruto de alta velocidad en una sola línea de exploración. Una vez claro el presupuesto de velocidad de datos —61,4 Gb/s en el frontend, 122 MB/s de subida—, sabe qué paso debe permanecer en el chip y cuál puede ir al host. En los ultrasonidos médicos el FPGA no es una tarjeta aceleradora: es la imagen misma.