Backhaul de fibra 10G/25G: planificación de la velocidad de línea GTX/GTH y descarga UDP
Cuando confluyen varios ADC de alta velocidad, haces de radar o flujos de vídeo, el cable de cobre alcanza su límite tras unos metros y PCIe no puede abandonar el chasis. El backhaul correcto es conducir SFP+/QSFP directamente desde los transceptores GTX/GTH del FPGA, descargar en el chip la MAC y la pila IP/UDP, y enviar solo la carga útil por fibra a velocidad de línea. Este artículo calcula la velocidad de línea 10G/25G, la carga útil UDP, el presupuesto óptico y la división interna de tareas del FPGA.
1. Por qué los datos de alta velocidad necesitan backhaul por fibra
Dentro de la placa se usa PCIe, y los enlaces cortos entre placas usan cobre; pero una vez que los nodos de adquisición están distribuidos, la distancia supera unos metros y cada canal mueve varios Gb/s o más, el cobre y el backplane chocan primero con su techo:
1. Techo de distancia: un cable DAC a 10G suele soportar solo 3–5 m, y el cobre activo también está limitado; la fibra monomodo con un módulo óptico alcanza fácilmente 10 km, adecuada para arrays de adquisición distribuidos y frentes de radar remotos.
2. Techo de ancho de banda: un solo 1080p60, una IF SDR multicanal o un IQ de radar fusionado suele superar los 10 Gb/s; el cobre gigabit y los backplanes no pueden transportarlo, por lo que se necesita SFP+ (10G) o QSFP28 (25G/100G).
3. Inmunidad de temporización y ruido: en entornos industriales ruidosos, la fibra proporciona aislamiento eléctrico, inmunidad al crosstalk y a bucles de tierra, y una temporización común más estable entre nodos.
El patrón típico: una tarjeta de adquisición remota solo hace el muestreo ADC y el preprocesado, empaqueta los resultados y los envía por una fibra a un servidor central, que no procesa los canales individualmente sino que solo recibe el flujo agregado. Aquí la velocidad de línea del enlace y la sobrecarga de protocolo deciden directamente cuántos nodos se pueden conectar.
2. Velocidad de línea 10G/25G y presupuesto de carga útil UDP (calcule primero la carga útil)
Muchos tratan un «puerto de 10 Gb/s» como ancho de banda utilizable, pero lo que llega a la capa de aplicación es la carga útil tras la codificación, el gap entre tramas y las cabeceras de protocolo. Parta de cómo surge la velocidad de línea:
| Ítem | 10G (SFP+) | 25G (QSFP28) | Nota |
|---|---|---|---|
| Velocidad Ethernet nominal | 10,0 Gb/s | 25,0 Gb/s | Velocidad MAC efectiva |
| Velocidad de línea codificada 64b/66b | 10 × 66/64 = 10,3125 Gb/s | 25 × 66/64 = 25,78125 Gb/s | Velocidad de bits real sobre el cable |
| Sobrecarga de trama MTU 1500 | Preamble/SFD 8B + gap 12B + Eth 14B + IP 20B + UDP 8B | Igual | ~62B no útiles por trama |
| Proporción de carga útil UDP | 1500/(1500+62) = 96,03 % | ≈96,03 % | Excluye retransmisión de capa de aplicación |
| Velocidad de carga útil UDP (MTU1500) | 10 × 96,03 % ≈ 9,60 Gb/s | 25 × 96,03 % ≈ 24,0 Gb/s | Lo que la capa de aplicación recibe realmente |
| Proporción Jumbo Frame (9000B) | 9000/9062 = 99,32 % | 99,32 % | Eleva la carga útil a ~9,93 / ~24,8 Gb/s |
Conclusión clave: sobre UDP con MTU1500, un puerto 10G entrega solo unos 9,6 Gb/s a la aplicación, no 10 Gb/s. Dimensiones los nodos por la carga útil: si cada nodo envía 2 Gb/s de datos efectivos, un enlace 10G sostiene unos 4–5 nodos (9,6 / 2, con margen), no los 5 completos. Para acercarse a la velocidad de línea, active Jumbo Frame y amortice la sobrecarga fija por trama.
BER y presupuesto óptico
Un enlace de fibra no está terminado una vez enchufado: primero calcule el presupuesto de potencia óptica: potencia de transmisión − sensibilidad del receptor = margen de enlace, del que deduce la atenuación de la fibra (monomodo 1310 nm ≈ 0,35 dB/km) y la pérdida por empalme/conector (~0,5 dB por conector). El SR multimodo 850 nm está limitado por la distancia y el OM3/OM4; el LR monomodo 1310 nm alcanza 10 km. Un enlace conforme busca un BER mejor que 1e-12; el 25G suele añade corrección de errores hacia delante RS-FEC, corrigiendo errores en bruto de ~1e-5 hasta 1e-15, así que incluya la ganancia de codificación del FEC en el presupuesto.
3. Cómo divide el trabajo el FPGA
1. Los transceptores GTX/GTH conducen el módulo óptico
El GTX de series 7 llega como máximo a 10,3125 Gb/s, igualando el SFP+ 10G; los GTH/GTY de UltraScale/UltraScale+ superan los 16G y soportan 25G. El transceptor se encarga de la serialización/deserialización, la codificación 8b/10b o 64b/66b y la recuperación de reloj; externamente solo quedan los pares de alta velocidad y la gestión I2C del módulo (lectura DDM).
2. MAC y procesamiento de tramas
Sobre el transceptor se sitúa la MAC Ethernet 10G/25G: delimitación de tramas, verificación CRC, control de flujo PAUSE. El Rx descarta tramas con CRC malo y filtra por MAC de destino; el Tx encapsula tramas y rellena los gaps. Esta capa es una tubería determinista adecuada para hardware completo.
3. Motor de descarga UDP
Dejar que la CPU empaquete IP/UDP por cada trama se convierte en un cuello de botella a 10G. Descarga en el chip: el hardware rellena la IP de origen/destino, los puertos y la checksum; el usuario solo escribe la carga útil en el buffer DMA, y el motor añade las cabeceras Eth/IP/UDP, calcula la checksum y fragmenta por MTU. La CPU no empaqueta, solo configura la tabla de direcciones una vez en la inicialización: esto es la descarga de la pila de protocolo.
4. Estadística de errores y monitorización de enlace
Los contadores en chip acumulan errores CRC, tramas descartadas y correcciones FEC, reportados periódicamente por el canal de gestión; también se recopilan los DDM del módulo: potencia Tx, potencia óptica Rx y temperatura, alertando pronto cuando el margen disminuye en lugar de esperar a que la imagen se rompa.
4. Caso de ingeniería: adquisición multinodo con backhaul por fibra 10G
Un sistema de adquisición distribuido tiene 4 nodos remotos; cada uno fusiona dos canales IF SDR y un canal de vídeo para un backhaul efectivo de ~2,2 Gb/s; el centro agrega por una fibra 10G, y con Jumbo Frame la carga útil es ~9,9 Gb/s, por lo que 4 nodos que suman 8,8 Gb/s dejan margen. Todos los protocolos se descargan por UDP en el FPGA; el host solo recibe la carga útil.
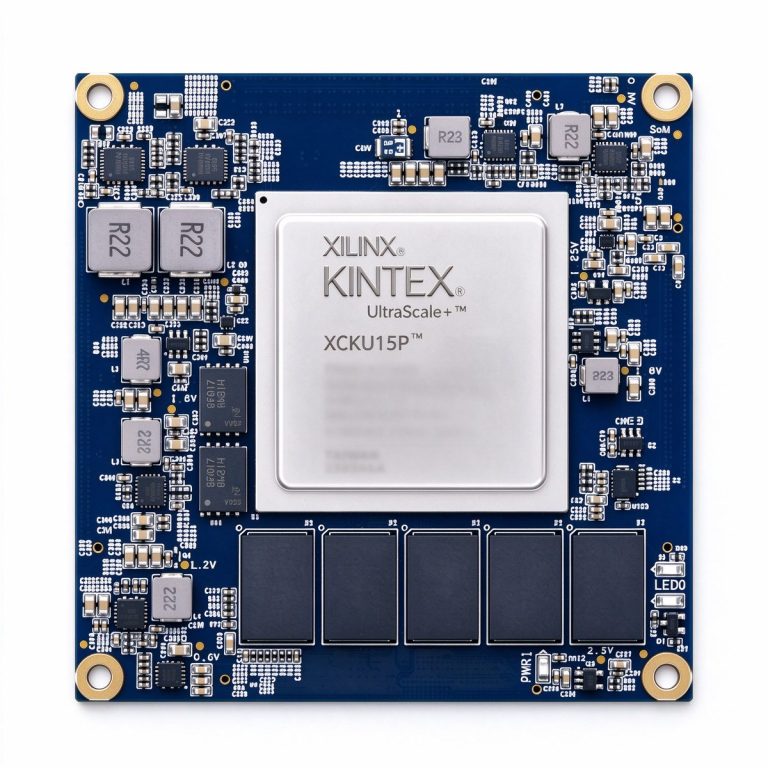
- Enlace de alto ancho de banda (XCKU15P / Kintex UltraScale+): amplio margen de transceptores GTY para 25G o varios carriles 10G, adecuado para un nodo agregador principal que pueda escalar a 25G/100G.
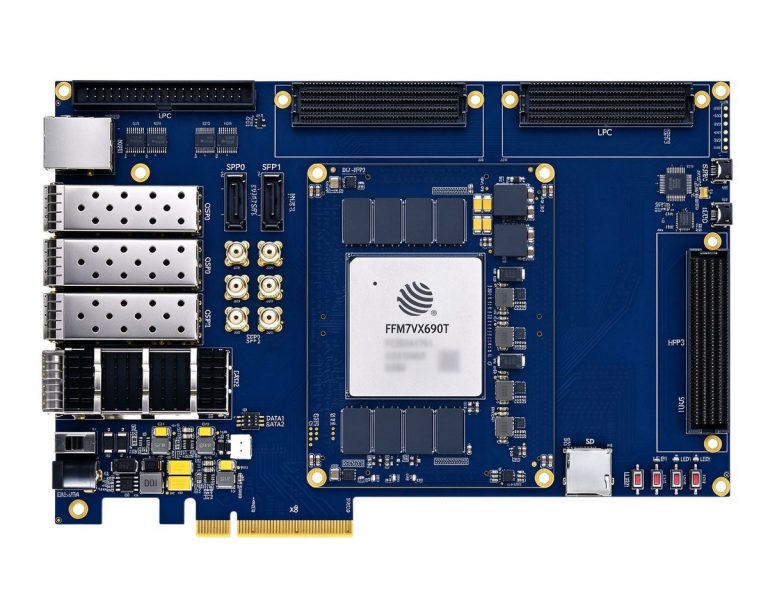
- Agregación de alta capacidad (DUF7690T / JFM7VX690T): amplia lógica y RAM en chip para varias MAC, motores de descarga UDP y colas grandes, adecuado para agregación central multinodo y reenvío a velocidad de línea.
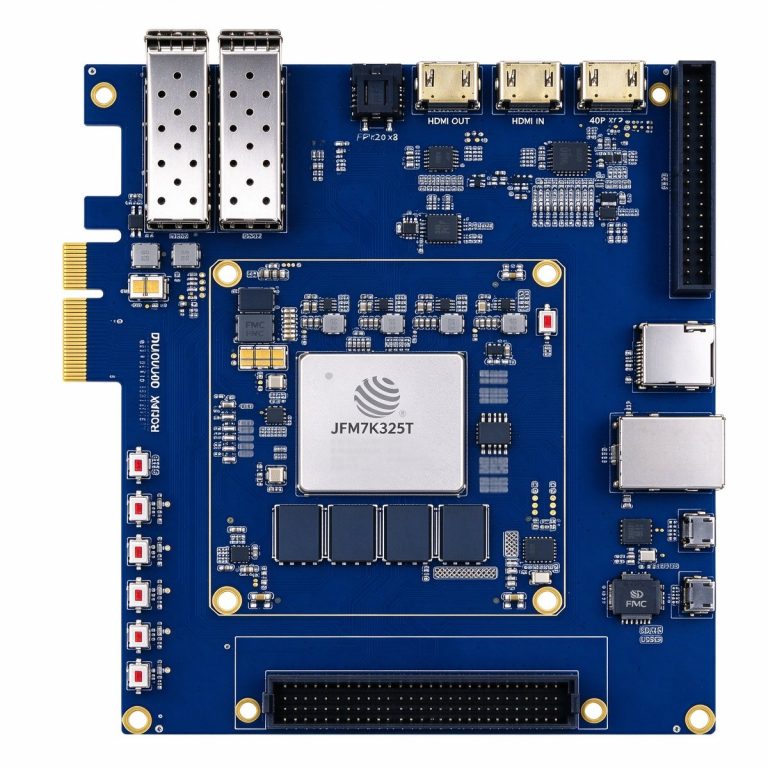
- Entrada de prototipo 10G (DUK7325T / JFM7K325T): el GTX de series 7 satura la velocidad de línea 10G con un coste equilibrado, adecuado para prototipo 10G de nodo único y productos de entrada.
El backhaul por fibra consiste, en esencia, en dejar que los transceptores del FPGA y la pila de hardware terminen «enviar a velocidad de línea» en nombre de la CPU. Retenga dos números: sobre MTU1500, 10G entrega ~9,6 Gb/s y 25G ~24 Gb/s de carga útil. Dimensiones los nodos por la carga útil y no por la velocidad nominal, calcule de entrada el presupuesto óptico y el BER, y el backhaul no perderá velocidad en campo.