Planificación del ancho de banda PCIe: cuánto ancho de banda neto obtiene realmente de Gen3 x4 a x16
La factura del ancho de banda PCIe es mucho más compleja que el número de la hoja de datos: el ancho de banda bruto, la sobrecarga de codificación, la sobrecarga de protocolo, la eficiencia del DMA y el cuello de botella de la DDR recortan cada uno esos «16 GB/s». Este artículo repasa Gen3 x4/x8/x16, llega hasta el equilibrio entre DDR y DMA, y ofrece un método reutilizable para estimar el ancho de banda neto.
1. Tres capas de ancho de banda: bruto, codificado y neto
Cuando ve «PCIe Gen3 x16» en una hoja de especificaciones, la intuición dice 16 GB/s. Ese número es en realidad la velocidad de bits bruta, no el ancho de banda que puede usar en su sistema. Entre medias se sitúan dos capas de pérdida:
| Capa | Cálculo Gen3 x16 | Resultado | Significado |
|---|---|---|---|
| ① Velocidad de bits bruta | 16 carriles × 8,0 GT/s | 128 Gb/s | Velocidad de símbolos bruta en el enlace |
| ② Ancho de banda tras codificación | 128 × 128/130 (Gen3 usa 128b/130b) | ≈ 126 Gb/s ≈ 15,75 GB/s | Velocidad de datos de carga útil tras la sobrecarga de codificación |
| ③ Ancho de banda neto real | 15,75 × eficiencia de transferencia (80 %–90 %) | ≈ 12,6 – 14,2 GB/s | Ancho de banda utilable real tras cabeceras TLP, descriptores DMA e interrupciones |
Gen3 funciona a 8,0 GT/s por carril con solo un 1,5 % de sobrecarga de codificación 128b/130b; por eso Gen3 es mucho más eficiente que Gen2 (que arrastra un 20 % de sobrecarga 8b/10b). Comparativa entre anchos:
| Ancho PCIe | Velocidad de bits bruta | Ancho de banda tras codificación | Ancho de banda neto típico (DMA de bloques grandes) |
|---|---|---|---|
| Gen3 x4 | 32 Gb/s | ≈ 3,94 GB/s | ≈ 3,2 – 3,5 GB/s |
| Gen3 x8 | 64 Gb/s | ≈ 7,88 GB/s | ≈ 6,3 – 7,1 GB/s |
| Gen3 x16 | 128 Gb/s | ≈ 15,75 GB/s | ≈ 12,6 – 14,2 GB/s |
| Gen2 x8 (referencia) | 40 Gb/s | ≈ 4,0 GB/s (8b/10b) | ≈ 3,2 – 3,6 GB/s |
2. Cuánta sobrecarga de protocolo: TLP, carga útil, lectura frente a escritura
El ancho de banda tras codificación no es el ancho de banda neto. Cada paquete de capa de transacción PCIe (TLP) lleva una cabecera de 12–20 bytes; cuanto mayor es la carga útil, menor es la proporción de cabecera y mayor la eficiencia.
El tamaño de la carga útil determina directamente la eficiencia
| Tamaño de carga útil | Proporción de cabecera TLP | Eficiencia de transferencia | Escenario típico |
|---|---|---|---|
| 4 KB (máximo) | ≈ 0,4 % | ≈ 90 %+ | Adquisición DMA continua de bloques grandes, flujos de vídeo |
| 512 B | ≈ 3 % | ≈ 85–88 % | Retorno general de datos |
| 64 B | ≈ 25 % | ≈ 55–65 % | Lectura/escritura de registros, control de paquetes pequeños |
Las lecturas son más lentas que las escrituras: el coste oculto de las Completion
Las escrituras PCIe son fire-and-forget; el emisor no espera el acuse. Las lecturas PCIe deben esperar a que vuelva un TLP de Completion: un viaje de ida y vuelta que duplica la latencia y consume ancho de banda. Medido:
- Escrituras secuenciales de bloques grandes: 88–92 % del ancho de banda tras codificación
- Lecturas secuenciales de bloques grandes: habitualmente solo el 80–85 % (cola de Completion, sobrecarga)
- Lectura/escritura mixta: el cambio de dirección provoca paradas del enlace, recortando la eficiencia otro 5–10 %
En la planificación de ingeniería, utilice la estimación conservadora «ancho de banda neto = tras codificación × 80 %», no la cifra ideal del 90 %+, para dejar margen de maniobra.
3. La DDR es el techo real
Un enlace PCIe rápido no significa que el sistema pueda funcionar a toda velocidad: los datos que entran y salen del FPGA deben cruzar la DDR, y el ancho de banda de la DDR suele ser el primer muro que se encuentra.
Cómo calcular el ancho de banda de la DDR
Ancho de banda DDR = anchura del bus de datos × velocidad de datos / 8. Para las placas habituales de Duyuan:
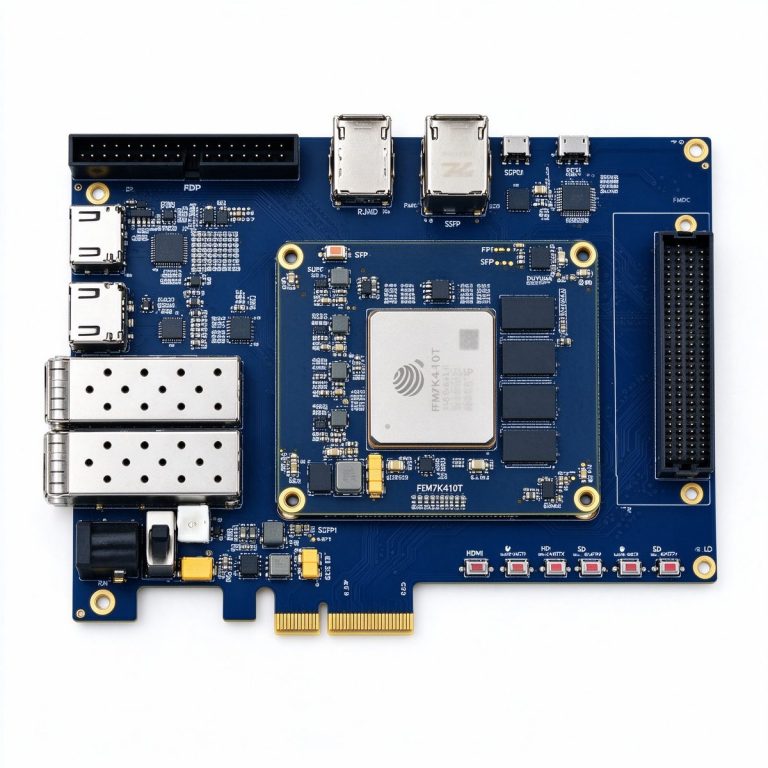
- DUK7410T: 4 GB DDR3, bus de 64 bits, 1866 Mbps → 64 × 1866 / 8 ≈ 14,9 GB/s
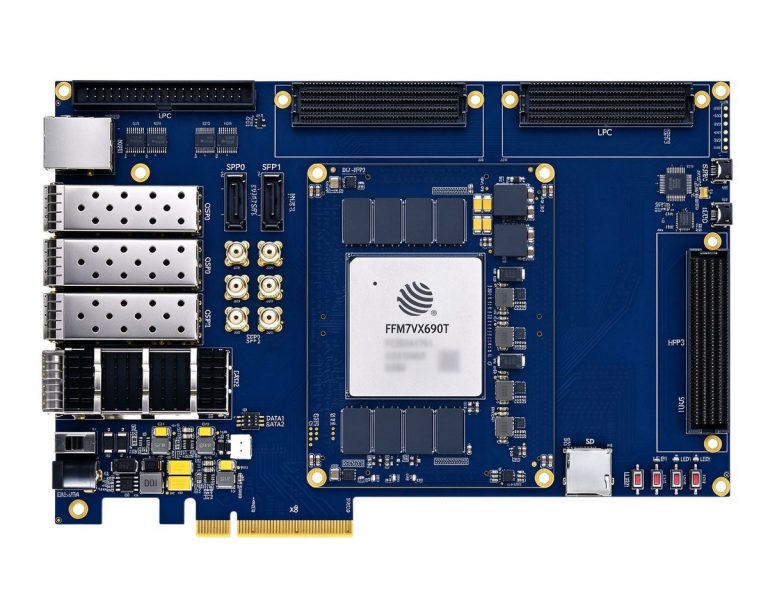
- DUF7690T: 4 GB DDR3, 64 bits, 1866 Mbps → ≈ 14,9 GB/s
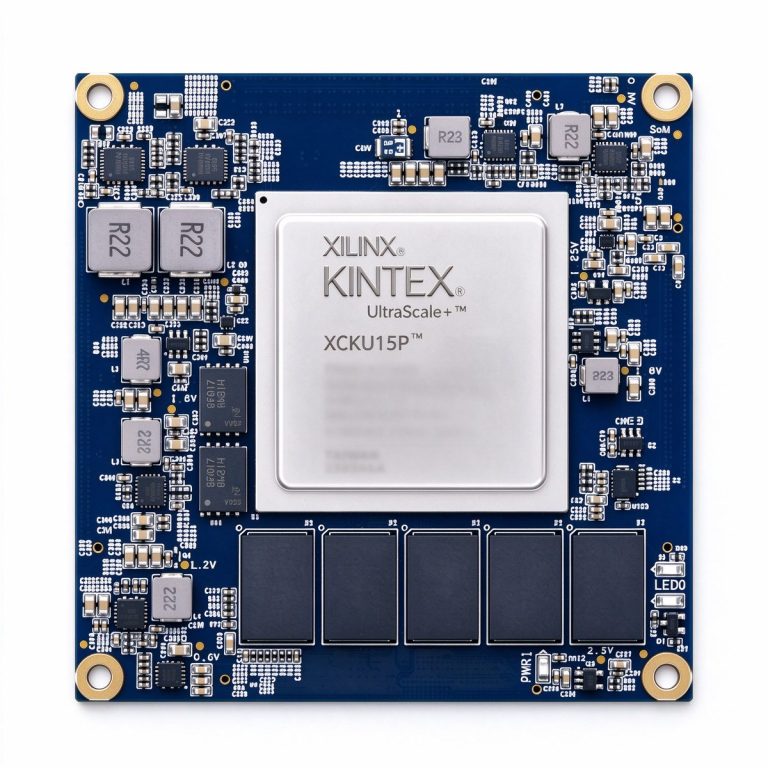
- DUKU15P: 8 GB DDR4 ECC, bus de 64 bits (+8 bits ECC) → a 2400 MT/s ≈ 19,2 GB/s
El flujo de datos es bidireccional: lectura + escritura duplican la carga
Considere un escenario de adquisición de alta velocidad: los datos del ADC los procesa el FPGA y se escriben de vuelta al host por PCIe. Ese camino de datos cruza la DDR dos veces:
- El FPGA recibe datos → escritura DDR (buffer de fotogramas)
- El FPGA termina el procesamiento → lectura DDR (los recupera para transmitir)
- Carga total de DDR = ancho de banda de escritura + ancho de banda de lectura
Si el ancho de banda neto de PCIe x8 Gen3 es de 7 GB/s, la DDR debe escribir simultáneamente 7 GB/s y leer 7 GB/s = 14 GB/s, acercándose al límite físico de la DDR3 de 14,9 GB/s, sin dejar casi nada para el algoritmo del FPGA. Por eso x8 Gen3 emparejado con DDR3 es la «combinación dorada», mientras que x16 exige DDR4.
| Placa | Especificación PCIe | Ancho de banda tras codificación | Configuración DDR | Ancho de banda DDR | Veredicto de ajuste |
|---|---|---|---|---|---|
| DUK7410T | Gen2 x8 | ≈ 4,0 GB/s | 4 GB DDR3 64 bits | ≈ 14,9 GB/s | PCIe es el cuello de botella; la DDR tiene margen |
| DUF7690T | Gen3 x8 | ≈ 7,88 GB/s | 4 GB DDR3 64 bits | ≈ 14,9 GB/s | ~7,5 GB/s en cada dirección, justo equilibrado |
| DUKU15P | Gen3 x16 | ≈ 15,75 GB/s | 8 GB DDR4 64 bits | ≈ 19,2 GB/s | La DDR se acerca a su límite a carga PCIE completa |
4. Estimación en tres pasos: ¿cuánto ancho de banda necesita su proyecto?
Metodología · 01: estimación del ancho de banda PCIe en tres pasos
Paso 1: calcule la demanda neta. Sume las velocidades de datos en bruto de todas las fuentes de datos: el volumen mínimo que debe desplazarse.
Paso 2: aplique un factor de redundancia. Multiplique por 1,2–1,5 para la sobrecarga, las ráfagas y el dúplex.
Paso 3: retrocalcule el ancho PCIe. Elija una especificación cuyo ancho de banda tras codificación sea ≥ la demanda redundada, y luego verifique que la DDR puede seguirle el ritmo.
Validado frente a tres escenarios habituales:
| Escenario | Velocidad de datos en bruto | Demanda tras redundancia | PCIe recomendado | Por qué |
|---|---|---|---|---|
| Adquisición de alta velocidad (2 canales × 250 MSPS × 14 bits) | ≈ 875 MB/s | ≈ 1,1 – 1,3 GB/s | Gen3 x4 (3,94 GB/s) | Amplio margen, DDR sin estrés |
| Captura y procesamiento de vídeo 4K60 (10 bits 4:2:2) | ≈ 1,5 GB/s | ≈ 1,8 – 2,3 GB/s | Gen3 x8 (7,88 GB/s) | Espacio para vídeo multicanal o composición |
| Retorno masivo de mapas de características de inferencia IA / vídeo 8K | ≈ 10 – 12 GB/s | ≈ 12 – 18 GB/s | Gen3 x16 (15,75 GB/s) | Requiere DDR4, o la DDR choca antes con el muro |
Una regla práctica: al elegir el ancho PCIe, retrocalcule desde la demanda neta × 2, y deje un margen completo de factor dos. El ancho de banda se puede ampliar, pero el ancho no se puede ampliar sin rediseñar la placa.
5. Elección entre las tres plataformas PCIe de Duyuan
DUK7410T (9 999 ¥): adquisición y procesamiento sensibles al coste
Fudan Micro JFM7K410T, IP dura PCIe Gen2 x8, ~4 GB/s tras codificación. Combínela con mezzaninas FMC HPC para adquisición de ADC de alta velocidad, o con procesamiento de vídeo HDMI 4K; empiece aquí cuando el ancho de banda PCIe no sea el cuello de botella.
DUF7690T (24 999 ¥): adquisición principal y procesamiento compuesto
Fudan Micro JFM7VX690T, IP dura PCIe Gen3 x8, ~7,88 GB/s tras codificación. Con 4 GB DDR3 a ~7,5 GB/s por dirección, iguala el ancho de banda completo x8. Plataforma principal para adquisición multicanal, procesamiento de señal de radar y composición de vídeo.
DUKU15P (15 999 ¥): retorno de datos de gama alta e interconexión 100G
AMD Kintex UltraScale+ XCKU15P, IP dura PCIe Gen3 x16, 15,75 GB/s tras codificación, emparejado con 8 GB DDR4 ECC. Integra 56 transceptores de alta velocidad (24× GTY 28G + 32× GTH 16G) e IP dura de Ethernet 4× 100G: la elección insignia para retorno PCIe de gran ancho de banda junto con red de alta velocidad.
El ancho de banda PCIe nunca es solo «velocidad de interfaz»: es la tabla más corta de entre «interfaz × memoria × DMA». Planifique primero el margen de la DDR, y luego hable de qué tan rápido puede ir PCIe.
>
— Equipo de I+D de Duyuan