Arrays multicámara a bordo: cómo el FPGA/MPSoC ejecuta inferencia de IA en tiempo real en el edge
Cuando cuatro cámaras en una línea alimentan todas a un servidor central para la detección, el ancho de banda no da abasto y la latencia no se puede comprimir. El mejor camino es hacer la captura, el preprocesado y la inferencia en la propia placa, enviando de vuelta solo los resultados de detección y una vista previa comprimida. Este artículo divide la arquitectura de IA a bordo del edge en roles PS/PL, con el presupuesto de ancho de banda y la ruta de despliegue del modelo.
1. Por qué llevar la inferencia de IA a la placa
El enfoque centralizado heredado en líneas multicámara: cada cámara alimenta un switch, los flujos en bruto vuelven a un servidor central, y una GPU del servidor ejecuta la detección sobre todo. Con pocas cámaras funciona, pero al aumentar los canales aparecen dos problemas: el ancho de banda en bruto sin comprimir es enorme, y la inferencia centralizada añade un inevitable recorrido de ida y vuelta por la red y latencia de cola.
Primero las cuentas del ancho de banda en bruto: un flujo en bruto único 1080p30, YUV422 (2 bytes por píxel) = 1920×1080×2×30 ≈ 124 MB/s ≈ 995 Mb/s; cuatro canales se apilan hasta unos 4 Gb/s de flujo sin comprimir, antes de la sobrecarga de decodificación, cola y codificación en el servidor. A esta escala, el coste del enlace y la latencia extremo a extremo de una arquitectura centralizada son difíciles de reducir.
El esquema a bordo invierte esto: la placa hace el preprocesado y la inferencia localmente, y solo envía resultados estructurados (caja delimitadora, clase, confianza, unos pocos KB por fotograma) más una vista previa comprimida; los píxeles en bruto nunca abandonan la placa.
2. Arquitectura de IA a bordo: qué manejan PS y PL
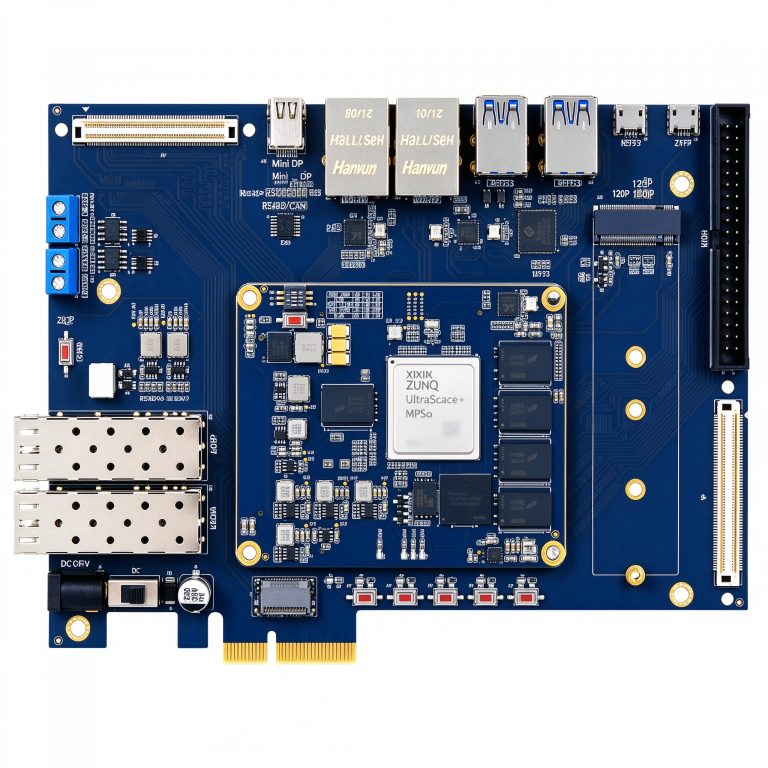
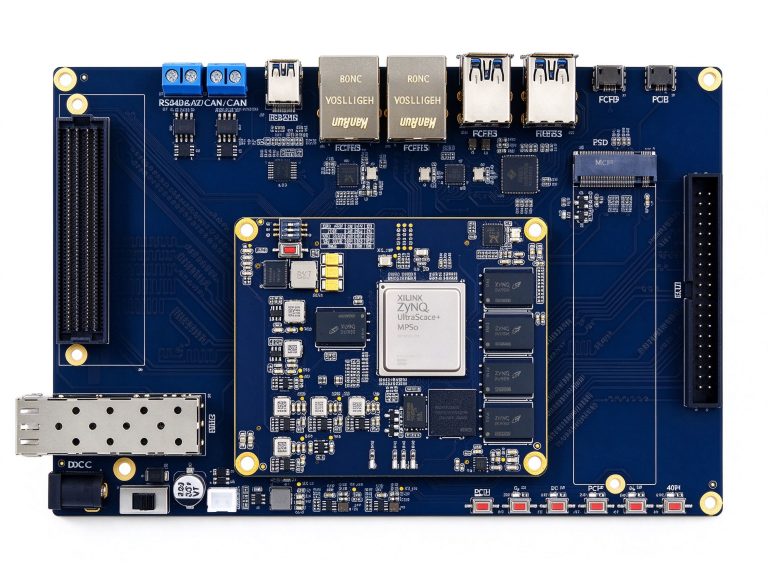
El Zynq UltraScale+ MPSoC sitúa un procesador de aplicación quad-core A53 (PS) y lógica programable (PL) en un solo chip, emparejando «planificación más sistema» con «caminos de datos paralelos».
1. PL: tubería de captura y preprocesado
Las señales de cámara (MIPI CSI, USB o GigE) entran en la PL, donde el paralelismo de hardware ejecuta primero la reducción de ruido, el escalado, la conversión de espacio de color y la normalización de formato. Estas operaciones son naturalmente por píxel y paralelas; una tubería PL las hace mucho más rápido que una CPU serie, y deja al A53 libre.
2. PL: inferencia paralela sobre modelos cuantizados
La convolución, el pooling y la activación se ejecutan en la PL como un array paralelo de slices DSP: los pesos residen en Block RAM/UltraRAM en chip o en la DDR4 del lado PL, y los mapas de características de entrada fluyen a través del array de multiplicar-acumular. Tras la cuantización INT8, el tamaño del modelo y el tráfico de memoria caen bruscamente. La PL no ejecuta ningún SO; su tubería determinista mantiene un compás fijo por fotograma.
3. PS: planificación, Linux y reporte de resultados
El PS quad-core A53 ejecuta Linux para la planificación de tareas, la comunicación con el host y el empaquetado de resultados; el codificador VCU integrado comprime simultáneamente un fotograma de vista previa a H.264/H.265 y lo envía por la red solo cuando una persona necesita verlo.
3. Presupuesto de ancho de banda: por qué el flujo multicámara en bruto no puede volver
| Etapa del enlace | 1080p30 único | Cuatro canales | Nota |
|---|---|---|---|
| En bruto sin comprimir (YUV422) | ~995 Mb/s | ~4,0 Gb/s | Enfoque heredado de retorno total al servidor |
| Resultado estructurado tras preprocesado | unos pocos KB/fotograma | unos pocos KB/fotograma | caja + clase + confianza |
| Vista previa comprimida (H.264) | 2–4 Mb/s | 8–16 Mb/s | Se envía solo cuando se visualiza |
El procesado a bordo recorta el ancho de banda de salida de Gb/s a Mb/s o incluso Kb/s; el servidor central recibe solo los resultados y ya no reserva decodificación ni inferencia por cámara. Esta frontera «los píxeles en bruto permanecen en la placa, solo salen los resultados» es la ventaja esencial del edge frente a un esquema centralizado.
4. Despliegue del modelo y elección de placa
1. Cuantice y pode primero
Cuantice el modelo a INT8 en la placa, pode y recorte pesos para reducir el volumen; luego divida las tuberías de capas según el almacenamiento en chip y la capacidad DSP, de modo que la tabla de pesos completa no tenga que entrar en el chip de golpe. Un flujo estilo Vitis-AI compila, cuantiza y despliega el modelo en unidades de aceleración PL, mientras el Linux del PS aloja la aplicación.
2. Elija una placa según el número de canales y el cómputo
<div class=”case”>
<h3>Roles de las placas de visión edge: prototipo de entrada / cómputo multicanal / paralelo Pure-FPGA</h3>
<ul>
<li><strong>Prototipo edge de entrada (DUUZ4EV, RFQ)</strong>: XCZU4EV, 192K celdas lógicas, 728 DSP, VCU integrado, PS 4 GB + PL 4 GB DDR4; para prototipos de IA edge de una a dos cámaras y validación rápida con PYNQ.</li>
<li><strong>Alto cómputo multicanal (DUUZ5EV, RFQ)</strong>: XCZU5EV, 256K celdas lógicas, 1 248 DSP, 16 pares GTH, expansión FMC-LPC; la plataforma para más canales y modelos más pesados.</li>
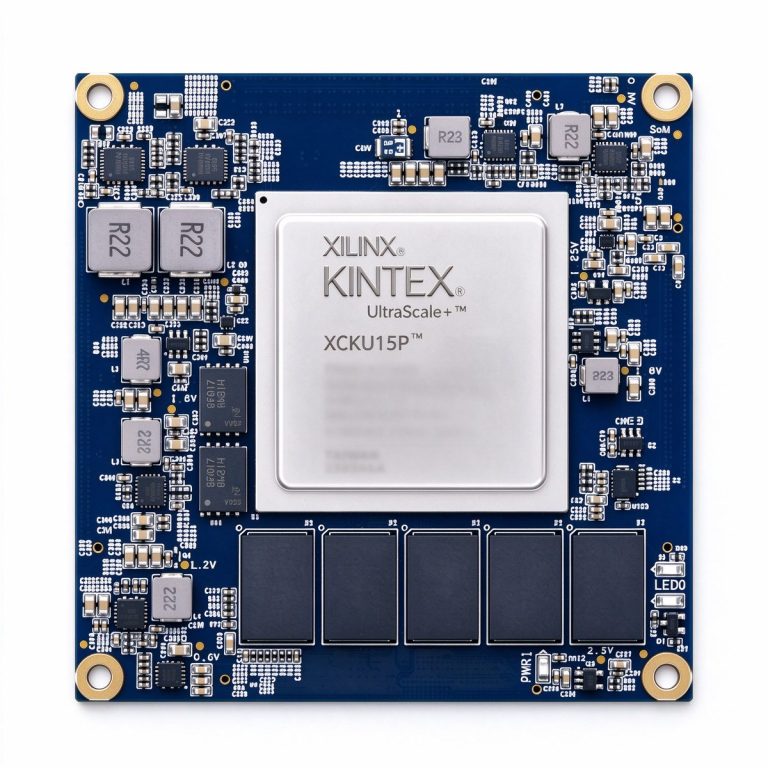
<li><strong>Expansión paralela Pure-FPGA (XCKU15P, 15 999 ¥)</strong>: core board Kintex UltraScale+ para procesamiento paralelo de flujos multicámara y agregación de alta velocidad donde no se necesita un sistema PS.</li>
</ul>
</div>
La inferencia de IA en el edge no consiste en reducir la GPU del servidor; significa rebanar toda la cadena «captura–preprocesado–inferencia–reporte» en la placa: la PL lleva el procesado paralelo de píxeles y la convolución cuantizada, el PS lleva la planificación y la comunicación, y el VCU comprime la vista previa de paso. Los píxeles en bruto permanecen en la placa y solo salen los resultados: tanto el ancho de banda como la latencia se relajan.