Plataforma de trading cuantitativo ultrarrápido en FPGA: cómo el VU13P ejecuta la cadena tick-to-trade en 300 ns
La esencia del trading cuantitativo es completar el bucle de información «llegada de datos de mercado → cálculo de señal → transmisión de orden» en el menor tiempo posible. Este artículo usa la plataforma AMD Virtex UltraScale+ XCVU13P (VU13P) como hilo conductor, explicando por qué encaja con el trading cuantitativo y cómo desplegarla en una cadena de trading de baja latencia entregable.
La esencia del trading cuantitativo es completar el bucle de información «llegada de datos de mercado — cálculo de señal — transmisión de orden» en el menor tiempo posible. En la escala de microsegundos del motor de emparejamiento de una bolsa, la latencia en sí misma es coste: llegar un microsegundo tarde significa deslizamiento de precio, oportunidades perdidas, o el fracaso de una estrategia entera. En la última década, las principales firmas de trading propietario han migrado progresivamente las partes más críticas de la cadena desde software en CPU hacia hardware en FPGA: decodificación de datos de mercado en la tarjeta, libro de órdenes en la tarjeta, decisiones de estrategia en la tarjeta, y generación de órdenes en la tarjeta. Este artículo usa la plataforma AMD Virtex UltraScale+ XCVU13P (VU13P) como hilo conductor, discutiendo por qué encaja con el trading cuantitativo y cómo desplegarla en una cadena de trading de baja latencia entregable.
1. La estructura de latencia del trading cuantitativo: por qué la respuesta es un FPGA
Una cadena típica de trading automatizado — desde que un paquete de datos de mercado llega a la NIC hasta que una orden abandona la NIC — pasa secuencialmente por la pila de red, el parseo de datos de mercado, el mantenimiento del libro de órdenes, el cálculo de señal, los controles de riesgo y la codificación de órdenes. En una pila de software, las interrupciones del kernel, el procesamiento de la pila de protocolos, la planificación de hilos y los fallos de caché introducen todos jitter incontrolable; la implementación hardware convierte estas etapas en una profundidad de tubería fija con latencia determinista, sin interrupciones y sin planificación. Latencia extremo a extremo tick-to-trade aproximada para distintos enfoques de implementación:
Tabla: comparativa de latencia extremo a extremo tick-to-trade (recopilada de fuentes públicas)
| Implementación | Latencia extremo a extremo típica |
|---|---|
| Software ordinario + pila de red del kernel | 10–100 µs |
| Software con bypass del kernel (DPDK / Onload + pinning de núcleo) | 1–5 µs |
| Cadena completa en FPGA (parseo → estrategia → orden) | 300 ns – 1 µs |
| Trigger pre-armado en FPGA (match de patrón y envío) | 30–100 ns |
| Switch de capa 1 (fan-out / replicación pura) | aprox. 5 ns |
Tres propiedades del FPGA determinan esta brecha de orden de magnitud: paralelismo — múltiples feeds de datos de mercado e instancias de estrategia se ejecutan simultáneamente en hardware sin competir; determinismo — sin interrupciones ni planificación, la latencia de procesamiento de cada paquete es fija, lo que importa por igual para el control de riesgo y la auditoría; proximidad — los puertos ópticos conectan directamente al FPGA, saltándose PCIe y la pila de protocolos, decodificando paquetes a medida que llegan. Los datos públicos de la industria lo confirman: ciertas soluciones anuncian una latencia tick-to-trade de ida y vuelta por debajo de 100 ns, el diseño de referencia de AMD con partners para CME alcanza una latencia de trigger pre-armado a nivel de 25 ns; un artículo de 2025 en *Computer Applications and Software* que describe un sistema de aceleración de datos de mercado de latencia ultra-baja basado en OpenCL alcanzó 678 ns mínimos de procesamiento de datos de mercado en un Alveo U50 con 38,4 Gbit/s de rendimiento, aproximadamente 12 veces la mejora de rendimiento frente al enfoque software.
2. Visión general de capacidades de la plataforma VU13P
VU13P pertenece a la familia AMD Virtex UltraScale+ y es un dispositivo representativo en el punto de equilibrio «escala de lógica × interfaz de alta velocidad». Según la documentación oficial de producto de AMD, sus especificaciones clave son:
Tabla: especificaciones clave del XCVU13P (fuente: página oficial de producto Virtex UltraScale+ de AMD)
| Métrica | Especificación XCVU13P |
|---|---|
| Celdas lógicas de sistema | 3 780K (aprox. 3,78 millones de celdas lógicas) |
| Slices DSP | 12 288 |
| Transceptores GTY de alta velocidad | 128 pares (hasta 32,75 Gb/s por par) |
| E/S de usuario | 832 |
| Interfaces de alta velocidad integradas | PCIe Gen3 x16, MAC Ethernet 100G, Interlaken 150G (bloques duros en die) |
| Cómputo DSP | hasta aprox. 38 TOP/s |
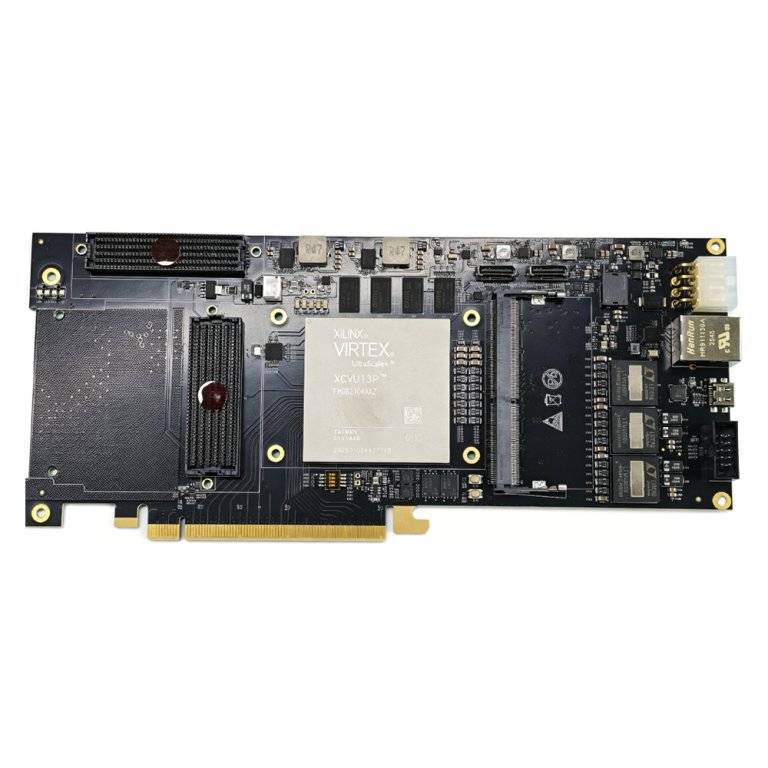
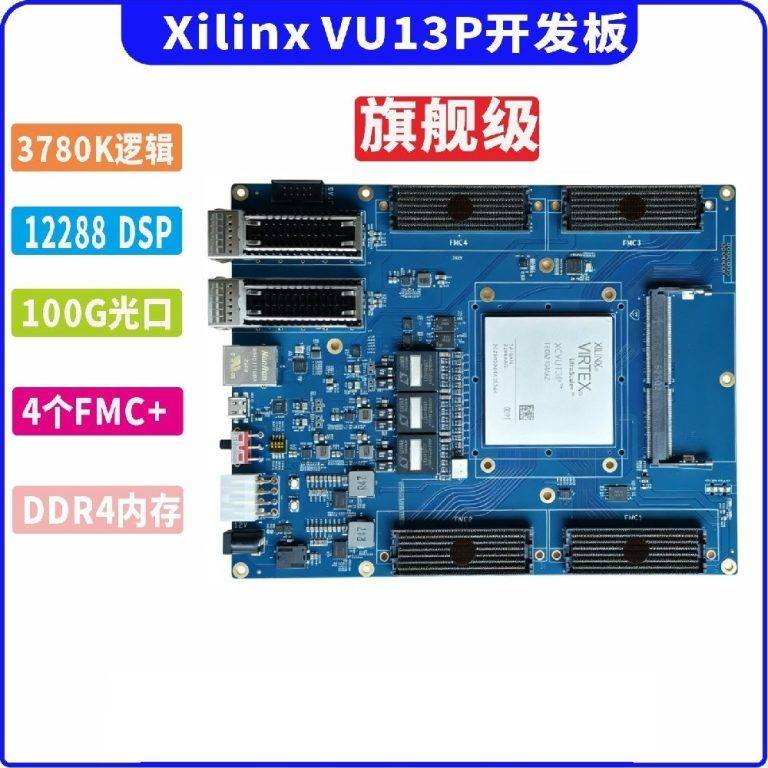
A nivel de placa, la plataforma de desarrollo ultra-gama del VU13P de Duyuan Electronics ofrece contactos dorados PCIe Gen3 x16, múltiples puertos ópticos 100G (QSFP28), expansión de alta velocidad FMC+, expansión DDR4 SODIMM, y un rango de temperatura industrial −40 °C a 85 °C. Para el trading cuantitativo, esta placa ofrece naturalmente tres cosas: conectar directamente múltiples feeds de bolsa al FPGA (puertos ópticos + GTY), colocar lógica de estrategia sustancial dentro del FPGA (3,78 millones de celdas lógicas + 12 288 DSP), y interconexión host bidireccional de alto ancho de banda (PCIe Gen3 x16).
3. Cuatro aplicaciones centrales del VU13P en la cadena de trading cuantitativo
3.1 Decodificación y preprocesado de datos de mercado (Feed Handler)
Los protocolos de datos de mercado de las bolsas (NASDAQ ITCH, CME MDP3, el formato FAST usado habitualmente por las bolsas europeas, etc.) llegan a tasas de paquetes extremadamente altas; el parseo por software requiere decodificación, validación y reconstrucción de estructura por paquete, convirtiéndose en el primer y más típico cuello de botella de la cadena. En el VU13P, el parseo de datos de mercado se implementa como una tubería hardware: los paquetes se decodifican como flujos de bytes al entrar en el puerto óptico, con extracción de campo, validación y reensamblado de protocolo completados dentro de etapas fijas de tubería, mientras múltiples feeds (múltiples bolsas, líneas primario/respaldo A/B) se procesan en paralelo. Los 128 transceptores GTY y los múltiples puertos ópticos 100G proporcionan una capacidad de conexión simultánea amplia; para las bolsas que publican mediante líneas duales primario/respaldo (como las líneas A/B de CME), la arbitraje de línea y la conmutación por error sin fisuras pueden implementarse en hardware para evitar huecos de datos de mercado causados por jitter de línea única. Las estructuras estándar de datos de mercado parseadas se escriben directamente en el almacenamiento en chip para los módulos de estrategia aguas abajo, sin pasar nunca por la CPU del host.
3.2 Libro de órdenes hardware y ejecución paralela de estrategias
Mantener un libro de órdenes consultable requiere frecuentes operaciones de inserción, borrado, modificación y ordenación; las implementaciones por software dependen del acceso a memoria y de locks, mientras que las implementaciones hardware mapean los niveles de precio directamente sobre estructuras Block RAM en chip, con la búsqueda de precio y la decisión de emparejado completadas en ciclos fijos. Sobre esta base, las 3,78 millones de celdas lógicas del VU13P permiten que múltiples instancias de estrategia se ejecuten en paralelo en un solo dispositivo: distintos instrumentos, distintos mercados, e incluso distinta lógica de estrategia (market making, arbitraje cross-market, arbitraje de latencia, regresión estadística) pueden ocupar particiones lógicas independientes, compartiendo el mismo flujo de datos de mercado parseado sin interferencias. Para estrategias de trigger sensibles a la latencia, puede usarse un enfoque de «orden pre-armada»: las plantillas de orden se escriben en el buffer de transmisión por adelantado, y cuando el hardware detecta la condición establecida (ruptura de precio, cambio en la ratio de volumen) dispara la transmisión directamente, saltándose el camino de decisión software, comprimiendo la latencia a decenas de nanosegundos.
3.3 Riesgo previo a la operación
Las bolsas y los marcos de cumplimiento imponen requisitos de riesgo cada vez más estrictos sobre el trading algorítmico: banda de precio, límites de cantidad por orden, posición diaria acumulada, frecuencia de órdenes y otros controles deben completarse antes de enviar una orden. El problema del control de riesgo por software es que se sitúa en el camino crítico y añade latencia; el control de riesgo por FPGA coloca la lógica de chequeo en paralelo junto al camino de órdenes: cada orden pasa por varias etapas de chequeo de riesgo en la tubería hardware, y se codifica y envía de inmediato al aprobarse, o se bloquea en nanosegundos al rechazarse. Las reglas de riesgo se configuran mediante registros/tablas de memoria y pueden actualizarse en caliente dentro de la sesión de trading, satisfaciendo los requisitos de cumplimiento sin sacrificar la baja latencia en el camino principal.
3.4 Backtesting, simulación y aceleración de I+D
Más allá de la cadena de producción, los grandes recursos de lógica del VU13P también soportan la I+D de estrategias: cargue motores de replay y simulación de datos de mercado en la placa de desarrollo para backtesting a nivel hardware contra datos históricos, ejecutando múltiples estrategias en paralelo; significativamente más rápido que la simulación software; use Vivado/Vitis HLS para mapear rápidamente algoritmos C/C++ a implementaciones hardware, acortando el ciclo de iteración «idea de estrategia → hardware testeable». Una organización de ingeniería típica es «el FPGA ejecuta el camino de producción, la CPU ejecuta monitorización y análisis»: el procesamiento de órdenes de producción y de datos de mercado ocurre por completo en la tarjeta, mientras el host lee el estado vía PCIe Gen3 x16 y empuja hacia abajo los parámetros de estrategia y las reglas de riesgo, equilibrando rendimiento y operaciones.
4. Arquitectura de sistema extremo a extremo típica
Una plataforma de trading cuantitativo basada en VU13P tiene una topología típica como la siguiente:
- Ingesta de datos de mercado: los feeds de bolsa entran en el FPGA directamente vía puertos ópticos 100G (QSFP28), con 128 pares GTY transportando múltiples líneas.
- Parseo hardware: los módulos Feed Handler decodifican, validan y arbitran las líneas A/B en una tubería según el protocolo (ITCH/FAST/MDP3, etc.).
- Libro de órdenes y señales: la BRAM en chip mantiene libros de órdenes para múltiples instrumentos, las particiones de estrategia calculan señales en paralelo, y se generan órdenes cuando se cumplen las condiciones de trigger.
- Riesgo y codificación: las órdenes pasan por controles de riesgo previos a la operación y se codifican en mensajes de protocolo de bolsa antes de entrar en el buffer de transmisión.
- Interconexión host: las confirmaciones de orden, los informes de ejecución y la monitorización de estado se envían al host vía PCIe Gen3 x16; los parámetros de estrategia y las reglas de riesgo se empujan hacia abajo desde el host.
- Interfaces de expansión: FMC+ se usa para conectar NICs personalizadas / mezzaninas aceleradoras; OCULINK para interconexión de alta velocidad board-to-board para escalado multi-placa.
En forma de despliegue, la placa de desarrollo VU13P puede servir directamente como una tarjeta aceleradora PCIe dentro de un servidor; para escenarios sensibles al espacio en rack y al consumo, puede personalizarse un factor de forma de core board de menor consumo basado en esta plataforma.
5. Ventajas de ingeniería del VU13P frente a otros enfoques
Tabla: perspectiva comparativa de plataformas de hardware para trading cuantitativo
| Dimensión | Ventaja relativa de VU13P (FPGA) |
|---|---|
| Latencia extremo a extremo | cadena completa 300 ns–1 µs, pre-trigger 30–100 ns; los enfoques software típicamente 1–100 µs |
| Determinismo de latencia | profundidad de tubería fija, sin jitter de interrupción/planificación, bueno para riesgo y auditoría |
| Capacidad paralela | 3 780K celdas lógicas + 12 288 DSP, múltiples estrategias/instrumentos simultáneamente |
| Ancho de banda de interfaz | 128× GTY, múltiples puertos ópticos 100G, PCIe Gen3 x16, ingesta multi-bolsa directa |
| Flexibilidad | reconfigurable: los cambios de estrategia son config/recarga, sin reemplazo de placa; ciclo de desarrollo mucho más corto que un ASIC |
| Umbral de desarrollo | más bajo que un ASIC; Vitis HLS/OpenCL mapea desde C/C++, los caminos clave se optimizan adicionalmente en RTL |
Frente a la CPU: el VU13P va una orden de magnitud por delante en latencia y determinismo; frente a la GPU: las GPU destacan en rendimiento por lotes pero la tubería y la planificación introducen jitter de latencia que las hace inadecuadas para caminos críticos de nanosegundos, mientras que la latencia determinista del VU13P encaja de forma natural; frente al ASIC: el ASIC tiene el mejor rendimiento pero un coste único y un ciclo de desarrollo prohibitivos, adecuado solo para algoritmos totalmente congelados, mientras que el VU13P retiene flexibilidad para la evolución de la estrategia. Es por esto que las firmas de trading propietario adoptan ampliamente «el FPGA para el camino crítico, la CPU/GPU para investigación y cómputo offline» como división de trabajo estándar.
6. Puntos esenciales de desarrollo y despliegue
- División de la cadena de herramientas: los caminos críticos (parseo de protocolo, codificación de órdenes) usan RTL para garantizar la latencia; la lógica de estrategia puede implementarse rápidamente con Vitis HLS / OpenCL, validando el comportamiento en simulación software primero, y luego sintetizando a hardware.
- Interfaces modulares: Feed Handler, Order Book, Strategy, Risk y Gateway usan uniformemente interfaces de datos AXI-Stream, facilitando el reemplazo, la reutilización y la colaboración en equipo.
- Reloj y sincronización: en despliegues multi-placa/multi-sitio, introduzca PTP/1PPS y un árbol de reloj de bajo jitter para unificar la base de tiempo, asegurando que los informes de ejecución y las marcas de tiempo de datos de mercado estén alineadas.
- Parta desde una placa estándar: primero complete el parseo de datos de mercado y la validación de estrategia en la placa de desarrollo VU13P, haga pasar la cadena de latencia, y luego personalice el factor de forma de la placa (número de interfaces, potencia, estructura mecánica) según las necesidades del proyecto.
- Monitorización y regresión: mantenga contadores de estadísticas y puntos de observación ILA en la lógica hardware, monitorice la latencia de tubería por etapa durante la sesión de trading, y cualquier degradación puede localizarse rápidamente.
7. Limitaciones y recomendaciones de selección
El FPGA no es la respuesta para todos los escenarios cuantitativos. Si una estrategia se reequilibra en horizontes de minuto u hora, o se apoya en características de aprendizaje automático a gran escala con iteraciones frecuentes de modelos complejos, las ventajas de coste y flexibilidad de la pila de software CPU/GPU son más obvias; si el equipo carece de capacidad de desarrollo hardware, el ciclo de evaluación, depuración y mantenimiento de un proyecto FPGA necesita una asignación completa. Cuando la baja latencia hardware se confirma como requisito, la selección del dispositivo puede estratificarse según las necesidades de recursos:
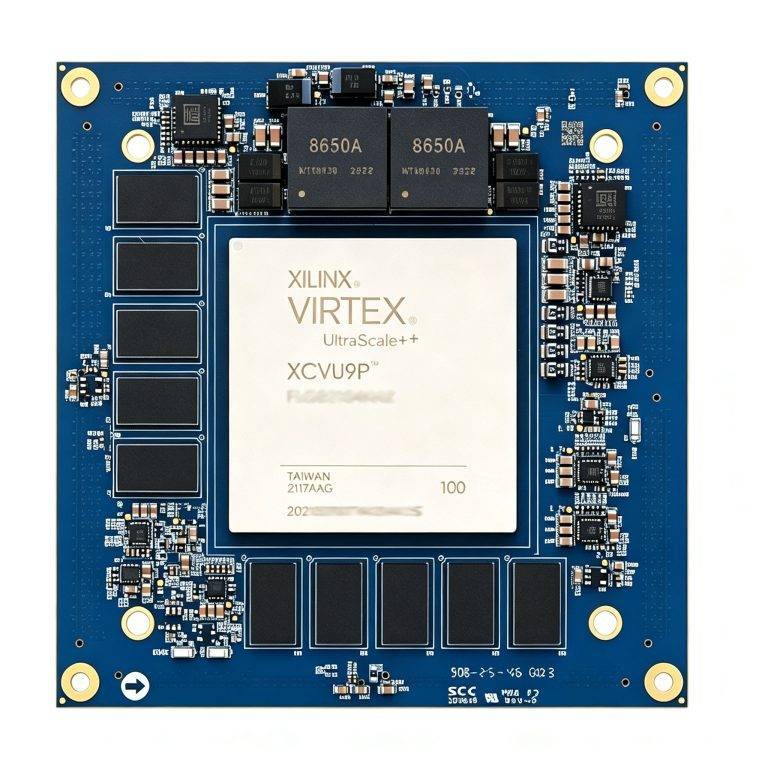
- VU9P: 2 586K celdas lógicas, 6 840 DSP, con 2×200G + 4×100G puertos ópticos, 32 GB DDR4 ECC, PCIe x16; adecuado para escenarios con ingesta de datos de mercado grande y énfasis en almacenamiento/ancho de banda.
- VU13P: 3 780K celdas lógicas, 12 288 DSP, 128×GTY; adecuado para multiestrategia paralela, lógica de estrategia compleja, y escenarios que necesitan más recursos en chip; la plataforma principal integral para esta clase de aplicaciones.
- VU13F: también 12 288 DSP, con 4×FMC+ proporcionando extensas E/S expandibles e interfaces de mezzanina; adecuado para integración a nivel de sistema que requiere NICs personalizadas, frentes de RF y otro hardware externo.
Nota: las cifras de latencia en este artículo son rangos típicos de fuentes públicas; los valores reales dependen de los protocolos, las tasas de paquetes, la implementación de la estrategia y el enrutado de la placa. La selección y la aceptación deben basarse en medición in situ.
8. Conclusión
La hardware-ización del trading cuantitativo es una tendencia que ha sido cierta durante años: desde el primer offload de NIC, hasta mover el parseo de datos de mercado y toda la cadena de órdenes al FPGA, hasta hoy en que un único dispositivo de clase VU13P transporta simultáneamente datos multi-mercado, multiestrategia y control de riesgo. El valor del VU13P reside en poner «escala» y «velocidad» en el mismo dispositivo: suficiente lógica y DSP para que combinaciones de estrategia complejas se ejecuten en paralelo en hardware, y suficientes GTY y puertos ópticos 100G para que la ingesta multi-bolsa ya no sea un cuello de botella. Duyuan Electronics proporciona placas de desarrollo estándar VU13P/VU9P, core boards personalizados, paquetes IP de decodificación de datos de mercado y de cadena de baja latencia, y soporte técnico extremo a extremo, ayudando a los equipos a moverse rápidamente desde la validación en placa de evaluación hasta una plataforma de hardware de trading cuantitativa desplegable.
Referencias
- AMD, página de producto FPGA Virtex UltraScale+ (especificaciones XCVU13P): https://www.amd.com/en/products/adaptive-socs-and-fpgas/fpga/virtex-ultrascale-plus.html
- AMD/Xilinx con LDA, solución de referencia CME Tick-to-Trade 25 nanosegundos: https://www.xilinx.com/publications/solution-briefs/partner/xilinx-lda-amd-tick-to-trade-solution-brief.pdf
- libfpga, FPGAs en trading de alta frecuencia: la anatomía de un nanosegundo (comparativa de latencia tick-to-trade): https://libfpga.com/blog/fpgas-for-hft
- semidesignjobs, FPGAs in High-Frequency Trading: A Technical Deep Dive: https://www.semidesignjobs.com/blog/fpga-hft-technical-deep-dive
- Enyx, nxFramework (plataforma tick-to-trade sub-100ns): https://www.enyx.com/nxframework/
- Computer Applications and Software 2025, diseño e implementación de un sistema de aceleración de datos de mercado de latencia ultra-baja basado en OpenCL: https://shcas.net/cn/article/doi/10.3969/j.issn.1000-386x.2025.03.003
- ACM, DSL Programmable Engine for High Frequency Trading Acceleration (aceleración del protocolo FAST): https://dl.acm.org/doi/pdf/10.1145/2088256.2088268
Duyuan Electronics · Aplicación Práctica | Datos a septiembre de 2026; distintas instituciones usan distintos ámbitos, todas las fuentes anotadas.